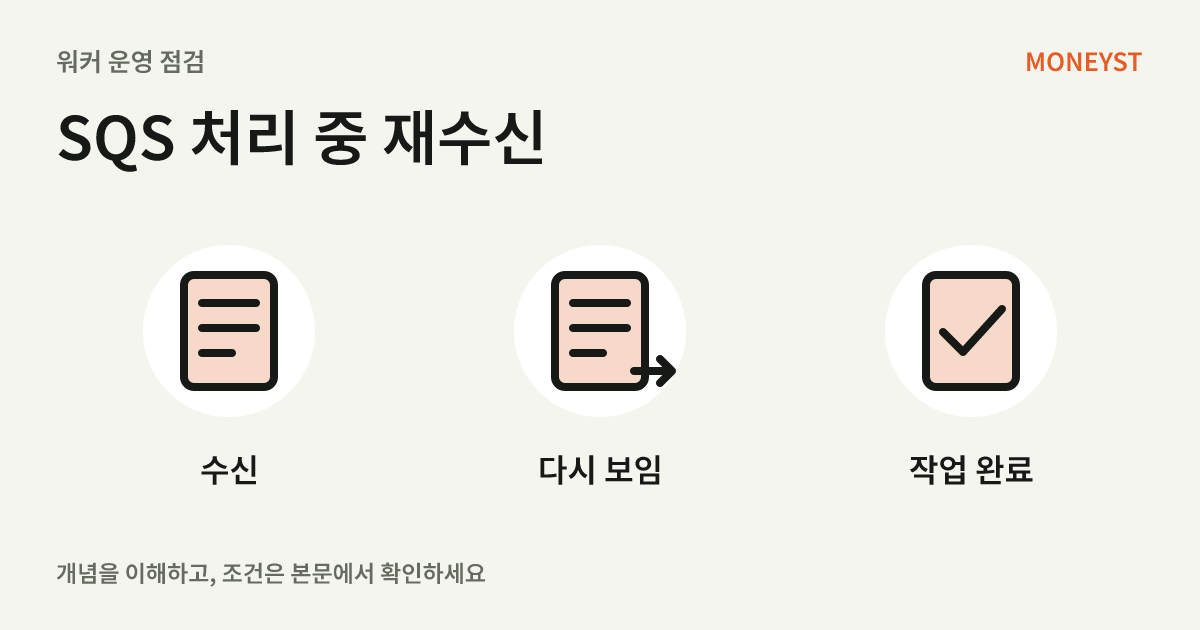
보고서 생성 워커가 아직 일하는데 같은 작업이 다른 워커에서도 시작된다면, 소비자 수를 늘리기 전에 SQS의 visibility timeout을 확인하자. 메시지를 받은 뒤 잠시 다른 소비자에게 보이지 않게 하는 기간이다. 이 기간이 작업 완료보다 짧으면 처리 중인 메시지가 다시 수신될 수 있다.
이 글은 직접 SQS를 폴링하는 표준 큐 워커를 기준으로 한다. Lambda 이벤트 소스 매핑의 설정 지침은 다루지 않는다. 2026년 10월 29일 공식 문서를 확인했으며 시간 예시는 실측이 아닌 가정이다.
30초는 메시지 보관 기간이 아니다
큐의 기본 visibility timeout은 30초다. 수신해도 메시지가 즉시 삭제되는 것은 아니며, 처리 후 삭제하기 전에 이 시간이 지나면 다시 보이게 된다. 반면 MessageRetentionPeriod는 큐에 메시지를 보관하는 기간으로 기본값은 4일이다. 비가시성 시간을 바꾸는 것과 보존 정책을 바꾸는 것은 별개의 결정이다. AWS 큐 속성 문서에서 두 값을 구분할 수 있다.
“처리 성공” 로그만으로 큐 삭제까지 완료했다고 판단하지 말자. 직접 작성한 워커라면 삭제 요청의 결과도 확인해야 한다. 사용하는 SDK나 라이브러리가 자동 삭제를 제공하는 경우에는 그 성공 조건과 오류 처리 방식을 점검한다.
90초 작업에서 생기는 60초의 빈틈
수신과 동시에 워커 A가 작업을 시작하고 정확히 90초 뒤 완료한다고 가정하자. visibility timeout은 30초이며 연장·조기 삭제는 없고, 보존 기간 만료 등 다른 제거 요인도 없다.
- 0초: 워커 A가 수신하고 작업을 시작한다.
- 30초: 비가시성 기간이 끝나 메시지가 다시 수신 가능해진다.
- 90초: 워커 A의 작업이 완료된다.
따라서 90 − 30 = 60초 동안 A가 계속 처리하면서 같은 메시지의 재수신도 가능한 상황이 된다. 이는 중복 처리 위험 구간의 가상 계산이다. 다른 워커가 정확히 30초에 받는다거나 반드시 두 번 실행된다는 뜻은 아니다. 실제 재수신 시점은 소비자의 폴링과 큐 상태 등에 달려 있다. AWS 비가시성 시간 설명을 바탕으로 구성한 예시다.
연장은 기존 마감에 숫자를 더하는 방식이 아니다
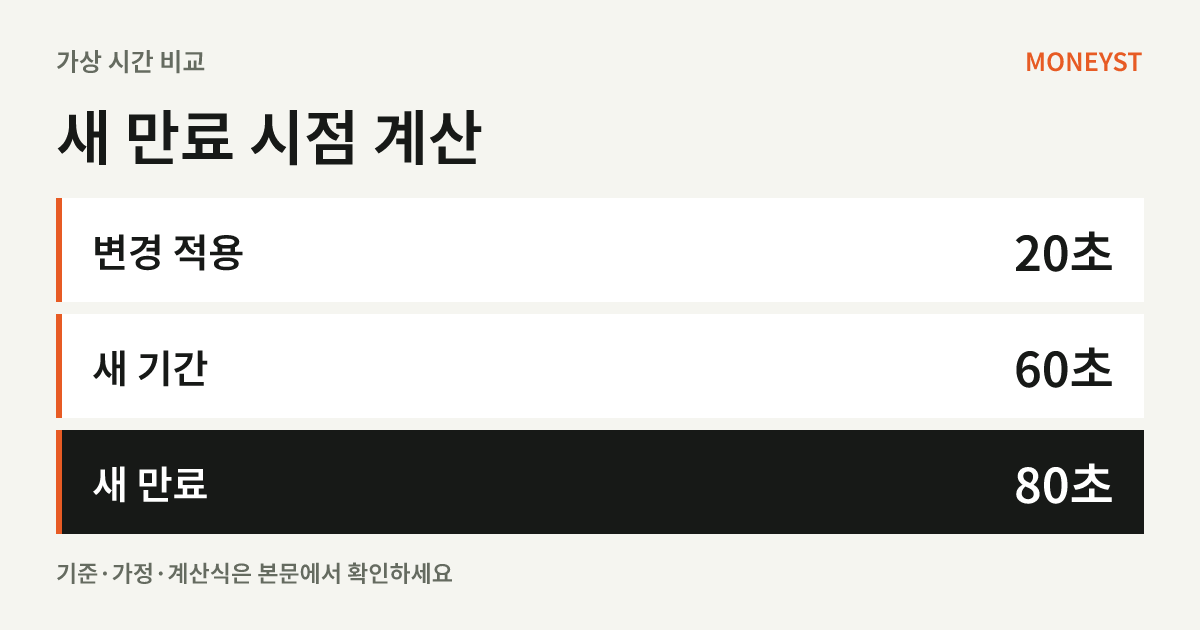
ChangeMessageVisibility로 60초를 설정하면 그 변경 시점부터 60초를 센다. 위 예시에서 수신 후 20초에 변경이 적용되면 새 만료 시점은 20 + 60 = 80초다. 기존 30초에 60초를 더한 90초가 아니다. 작업이 90초 걸린다면 이 한 번의 변경만으로는 끝까지 가리지 못한다.
수신 후 70초에 다시 60초 변경이 성공적으로 적용되면 새 만료는 130초다. 이 계산은 네트워크 지연을 무시하고 변경 적용 시점을 정확히 20초·70초로 둔 가정이며, 운영용 권장 주기를 뜻하지 않는다. 작업 완료와 삭제에 필요한 시간을 포함해 여유를 정하고, 만료 직전까지 기다리지 않는 heartbeat 방식이 필요하다.
개별 메시지에 바꾼 값은 다음 수신 때까지 계속 저장되는 설정이 아니다. 또 연장으로 최초 수신 기준의 12시간 상한이 재설정되지는 않는다. 허용된 잔여 최대시간보다 큰 값을 요청하면 자동 보정 대신 오류가 날 수 있다. ChangeMessageVisibility 문서를 확인하자.
시간 설정과 별도로 중복에 안전해야 한다
표준 큐는 적어도 한 번 전달하는 방식이므로 비가시성 기간 안에도 중복 전달을 절대적으로 배제할 수 없다. AWS는 같은 메시지를 다시 처리해도 문제가 생기지 않는 멱등 처리를 권고한다. 표준 큐 전달 특성이 근거다.
운영 설계 예로 보고서 작업 ID와 완료 결과를 함께 저장하고, 동일 작업이 다시 들어오면 이미 확정된 결과를 확인하도록 만들 수 있다. 단순히 “처리 시작” 표시를 영구 중복 차단으로 쓰면 워커 장애 뒤 정상 재시도까지 막을 수 있다. 진행 중 상태의 만료·재시도와 결과 확정의 원자성을 함께 설계해야 한다. 이 부분은 공식 문구의 복제가 아닌 작업 관리 체크리스트다.
삭제에는 MessageId 대신 가장 최근 수신에서 받은 ReceiptHandle을 사용한다. 오래된 핸들은 요청이 성공해도 메시지가 삭제되지 않을 수 있다. DeleteMessage 문서의 주의사항이다. FIFO로 바꾸는 것만으로 애플리케이션의 모든 부수 효과가 한 번만 발생한다고 가정해서도 안 된다.
배포 전 실패 시나리오 세 가지
- 느린 정상 작업: 예상보다 오래 걸리게 해 heartbeat가 제때 성공하고 완료 후 삭제되는지 확인한다.
- 작업 중 워커 종료: 새 소비자가 재수신해 이어 갈 수 있는지, 진행 중 표시가 영구 장애가 되지 않는지 확인한다.
- 결과 저장 후 삭제 실패: 같은 작업을 다시 받아도 결과가 중복 생성되지 않는지 확인한다.
설정을 크게 늘리면 장애 후 재등장이 늦어질 수 있다. 처리 시간 분포, 연장 실패, 삭제 실패, 재수신 및 중복 억제 기록을 함께 보며 조정하자. 특정 시간 값이 모든 큐에 최적이라는 보장은 없다. 배치 호출과 과금 구분은 SQS 메시지 1000개의 호출 수 계산 글에서 별도로 다뤘다.
본문 시간 계산은 실행 횟수·API 호출량·청구액 예측이 아니며 통화·세금·약정 조건을 제시하지 않는다. 공식 출처와 가정을 AI 에이전트가 검토했으며, 독자 시스템에서 수행한 실험이나 사람 검수로 표시하지 않는다.