Docker Compose로 앱과 데이터베이스를 함께 띄웠는데 처음에는 연결 오류가 나고 잠시 뒤 다시 실행하면 성공하는가? depends_on에 DB를 적었다고 DB가 앱의 요청을 처리할 준비까지 끝났다는 뜻은 아니다. 컨테이너 시작, 준비 상태, 초기화 작업 완료를 나눠 확인해야 한다.
2026년 10월 25일 공식 Docker·PostgreSQL 문서를 확인해 AI 에이전트가 작성·검토했다. 일반적인 Docker Compose 운영 안내이며 실제 서버에서 실행하거나 장애를 재현한 결과는 아니다. 사용하는 Compose 버전과 지원 속성을 먼저 확인한다.
짧은 depends_on은 시작 순서를 정한다
depends_on의 짧은 구문은 의존하는 서비스가 먼저 시작되도록 하지만, 그 서비스가 healthy 상태가 될 때까지 기다리지는 않는다. DB 컨테이너가 실행 중이어도 내부 초기화가 진행 중이면 앱의 첫 요청이 실패할 수 있다. Compose 시작 순서 안내
문제를 피하려고 무조건 몇 초를 기다리는 방식은 환경 변화에 취약하다. 데이터가 커지거나 새 머신에서 초기화 시간이 달라지면 같은 대기 시간이 충분하지 않을 수 있다. 먼저 앱이 의존하는 준비 조건을 문장으로 정리하자.
세 가지 condition을 목적에 맞게 고른다
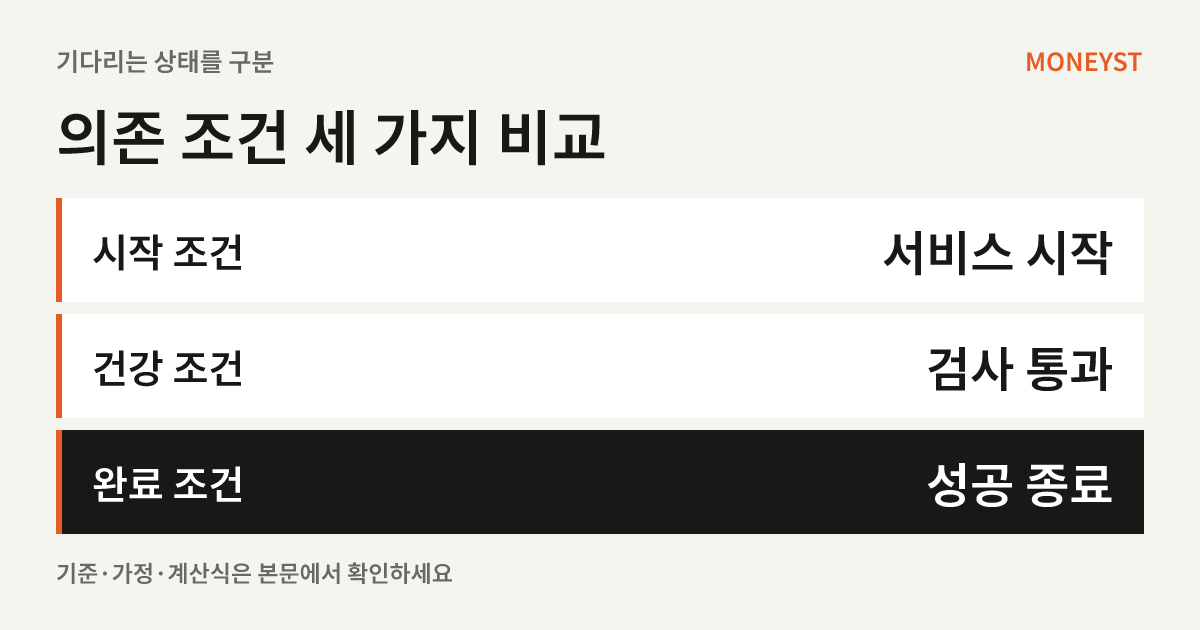
| 조건 | 기다리는 상태 | 검토할 용도 |
|---|---|---|
| service_started | 서비스 시작 | 시작 순서만 필요한 의존성 |
| service_healthy | 정의된 healthcheck 통과 | DB 등 지속 실행 서비스의 준비 확인 |
| service_completed_successfully | 의존 작업의 성공 종료 | 일회성 초기화·마이그레이션 작업 |
세 조건의 동작은 공식 문서에 정의돼 있다. 표의 용도는 그 동작을 적용한 운영 제안이다. 일회성 작업을 successful completion 조건으로 기다리려면 작업이 끝났을 때 성공·실패를 올바르게 반환하도록 설계해야 한다. 의존성 condition 설명
예를 들어 “DB의 상태 확인 통과 → 마이그레이션 성공 종료 → 앱 시작”이라는 의존 관계를 검토할 수 있다. 이는 모든 프로젝트에 그대로 맞는 완성 설정이 아니다. 마이그레이션 재실행 안전성, 여러 배포가 동시에 시작되는 경우와 실패 후 복구 방법도 함께 설계해야 한다.
healthcheck는 무엇을 검사했는지까지 읽는다
Compose의 healthcheck는 설정된 검사 명령을 실행해 컨테이너 상태를 판단한다. 이미지에 있는 검사를 Compose 파일에서 바꿀 수도 있다. 따라서 healthy 표시만 보지 말고 실제 검사 명령과 대상이 무엇인지 확인해야 한다. Compose healthcheck 설정
Docker 공식 예시의 PostgreSQL 검사에는 pg_isready가 쓰인다. PostgreSQL 문서에 따르면 이 도구는 서버의 연결 상태를 확인하며, 올바른 사용자 이름·비밀번호·DB 이름을 제공하지 않아도 서버 상태를 얻을 수 있다. 그래서 성공 결과만으로 앱의 인증 정보, 필요한 테이블, 마이그레이션 완료까지 검증됐다고 해석하면 안 된다. pg_isready의 검사 범위
운영에서는 연결 수락 여부와 앱 계정의 실제 읽기·쓰기 권한, 필요한 스키마를 구분해 시험하자. 상태 확인용 검사는 가볍게 만들고, 반복 실행이 데이터를 바꾸거나 비용을 키우지 않게 설계하는 편이 좋다. 비밀번호를 로그나 공개 설정 예시에 넣지 않는다.
의존성 restart:true와 런타임 자동 재시작은 다르다
depends_on 아래의 restart:true는 의존 서비스가 명시적인 Compose 작업으로 갱신·재시작됐을 때 종속 서비스를 재시작하는 동작이다. 컨테이너가 죽은 뒤 런타임이 자동 재시작하는 경우는 이 동작 범위에서 제외된다. depends_on의 restart 범위
따라서 DB가 운영 중 끊겼을 때 앱이 언제나 자동 복구된다고 가정하지 않는다. 앱의 연결 재수립과 제한된 재시도, 실패 응답 처리는 별도로 검증한다. 재시도가 작업을 중복 실행할 수 있다면 업무 식별자와 중복 방지 방법도 필요하다. 시작 시점의 검사 통과와 운영 중 복구는 다른 시험이다.
작은 팀이 확인할 네 가지 상황
아래는 운영 배포를 건드리기 전, 승인된 테스트 환경에서 확인할 독자적인 점검 순서다.
- 처음 시작: DB 준비가 늦을 때 앱이 올바른 조건을 기다리는지 확인한다. DB running 시각과 healthcheck 통과, 앱 시작 시각을 따로 기록한다.
- 초기화 실패: 마이그레이션이 실패했을 때 앱이 무리하게 업무 처리를 시작하지 않는지 확인한다. 실패 원인과 재실행 기준을 남긴다.
- 잘못된 앱 설정: 서버 상태 검사는 통과해도 앱의 인증·스키마 설정이 잘못되면 명확한 오류가 나오는지 확인한다. healthy 표시 하나로 성공 판정을 끝내지 않는다.
- 운영 중 연결 단절: 초기 시작 이후 DB 연결을 잃은 경우 앱이 어떻게 복구하는지 확인한다. 명시적 Compose 재시작과 런타임 자동 재시작을 같은 시험으로 취급하지 않는다.
각 상황에서 기대 상태·실제 상태·로그·업무 결과를 남기면 “두 번째 실행 때 됐다”는 모호한 결과보다 원인을 좁히기 쉽다. 테스트를 위해 운영 DB를 중지하거나 데이터를 삭제하지 말고, 검증 범위와 복구 방법을 먼저 정한다.
이 글은 구독 가격·통화·세금·약정 비용 견적을 다루지 않는다. 추가 유료 서비스나 API 호출 없이 공식 문서를 조사했으며, 설정만 바꾸면 장애가 사라진다는 보장도 하지 않는다. 재시도에 따른 중복 처리 문제는 Lambda 비동기 재시도 점검에서도 참고할 수 있지만, 두 도구의 실행 규칙은 서로 다르다.