Kubernetes에서 메모리 사용률이 낮은데 새 Pod가 Pending 상태로 남거나, 배치에는 성공했지만 피크 시간에 컨테이너가 종료되는 일이 있다. 이때 현재 사용량만 보거나 limits 합계를 곧바로 노드 구매량으로 해석하면 원인을 놓치기 쉽다.
2026년 10월 23일 공식 문서를 확인해 AI 에이전트가 작성·검토했다. 아래는 일반적인 Linux 컨테이너의 메모리 운영 설명과 가정 계산이며, 실제 클러스터 실측이나 특정 클라우드 요금 견적이 아니다.
requests와 limits는 서로 다른 질문에 답한다
메모리 request는 주로 Pod 배치 판단에 쓰인다. 실제 사용량이 낮아도 요청량 기준으로 들어갈 노드가 없으면 배치되지 않을 수 있다. 여유 자원이 있으면 컨테이너는 request보다 많이 사용할 수 있다.
메모리 limit는 실행 중 적용되는 제한이다. Linux의 메모리 제한은 OOM 종료를 통해 반응적으로 적용되므로, 설정 값을 조금 넘는 순간 반드시 정확히 멈추는 계량기처럼 보면 안 된다. Kubernetes 자원 관리 문서
운영 기록에서는 “배치에 사용되는 요청량”, “설정한 제한”, “관측한 사용량”을 별도 칸에 두자. 앞의 두 값은 설정이고 마지막 값은 시간에 따라 변하는 측정값이다.
Pod 8개의 메모리 합계 계산
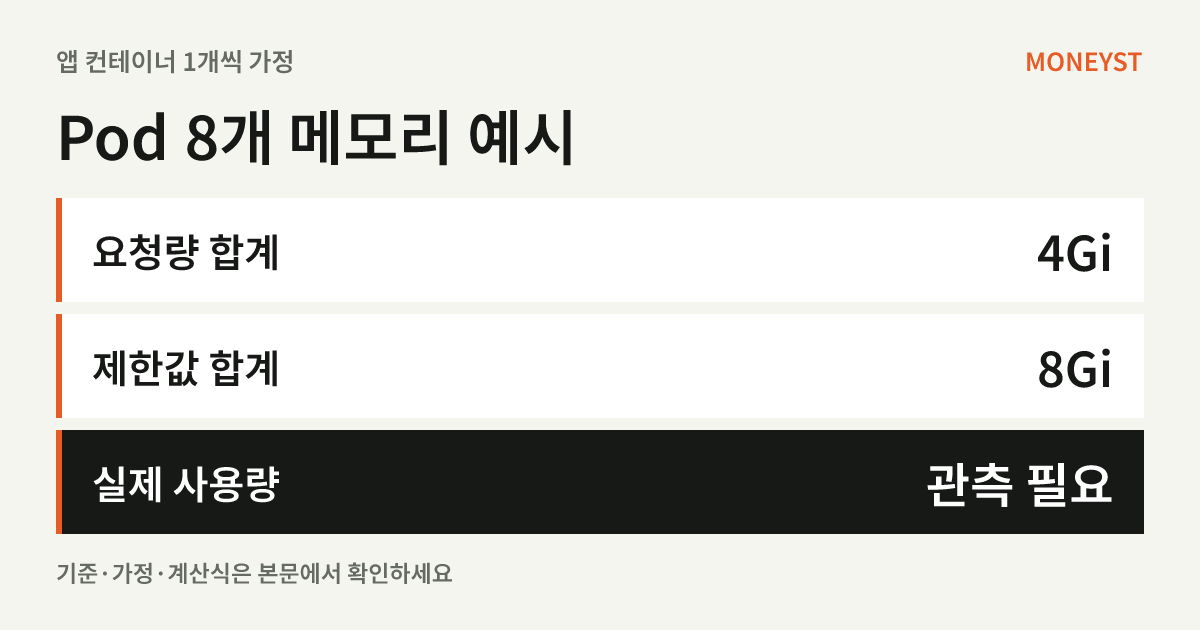
Pod가 8개이고 각 Pod에 앱 컨테이너가 하나씩 있다고 가정한다. 모든 컨테이너의 memory request는 512Mi, memory limit는 1Gi로 명시했다. 사이드카·초기화 컨테이너·Pod 오버헤드와 별도 Pod 수준 자원 설정은 없는 단순 모델이다.
| 항목 | 계산 | 합계 |
|---|---|---|
| 메모리 requests | 8 × 512Mi | 4,096Mi = 4Gi |
| 메모리 limits | 8 × 1Gi | 8Gi |
| 실제 메모리 사용 | 실행 후 관측 필요 | 이 설정만으로 알 수 없음 |
1Gi는 1,024Mi이며, 여기서는 각각 이진 단위인 GiB·MiB에 해당한다. 4Gi는 요청 설정의 합계이고, 지금 물리 메모리 4Gi를 사용하고 있다는 뜻이 아니다. 8Gi도 제한 설정을 더한 값일 뿐, 동시에 그만큼 사용할 수 있는 노드 여유가 확보됐다는 보장은 아니다. 메모리 제한의 반응적 특성 때문에 합계를 순간 사용량의 절대 상한으로 단정해서도 안 된다.
실제 Pod에 컨테이너가 더 있거나 초기화 과정·오버헤드·Pod 수준 자원 설정이 있으면 그 구성의 계산 규칙을 따로 확인해야 한다. 이 예시를 앱 컨테이너만 세는 보편적인 산식으로 사용하지 않는다.
노드 용량 대신 Allocatable부터 확인한다
Node Allocatable은 Pod에 제공할 수 있는 자원량이다. 시스템 데몬 등에 필요한 예약을 고려하므로 장비나 VM의 전체 메모리 용량과 같다고 가정하면 안 된다. 공식 문서에 따르면 노드 API와 kubectl describe node에서 확인할 수 있다. 시스템 자원 예약과 Allocatable
예를 들어 한 노드의 memory Allocatable이 6Gi이고, 기존 다른 Pod들의 요청량 합계가 1Gi라고 가정하자. 메모리 요청량 산술상 남은 몫은 5Gi다. 앞의 신규 Pod 8개는 총 4Gi를 요청하므로 이 산술만 보면 1Gi가 남는다.
하지만 이것은 실제 메모리 여유 1Gi를 측정했다는 뜻도, 8개 모두 배치된다는 보장도 아니다. CPU·다른 자원·배치 조건을 함께 확인해야 한다. 여러 노드의 남은 양을 한 덩어리처럼 합산하면 개별 Pod가 들어갈 공간이 없다는 문제도 놓칠 수 있다. 더구나 limits 합계 8Gi를 동시에 쓰려고 하면 이 노드의 메모리 여유와 충돌할 수 있다.
Pending·OOM·퇴거를 같은 문제로 취급하지 않는다
먼저 어느 단계에서 실패했는지 나눈다. 배치 전 Pending과 실행 중 컨테이너 종료는 조사할 증거가 다르다. Pending이면 이벤트의 실제 배치 실패 이유를 읽고, 종료라면 컨테이너의 마지막 상태와 재시작 기록을 확인한다.
노드에 메모리 압박이 생기면 kubelet은 Pod를 퇴거시킬 수 있다. 메모리를 회수하기 전에 노드 OOM이 발생하면 커널의 OOM 처리도 개입할 수 있다. Pod 퇴거와 컨테이너 OOM 종료는 같은 사건이 아니며, OOM으로 종료된 컨테이너는 restartPolicy에 따라 재시작될 수 있다. 노드 압박에 따른 퇴거 문서
따라서 request만 낮춰 배치 문제를 없애거나 limit만 높여 종료 문제를 없애려 하지 말자. 실제 병목이 메모리 누수인지, 피크 부하인지, 노드 자원 경쟁인지 확인하지 않으면 문제가 다른 위치로 옮겨갈 수 있다.
설정을 바꾸기 전 남길 운영 체크리스트
- 실제 적용 값: 배포 파일뿐 아니라 실행 중인 Pod에 적용된 requests·limits를 확인한다. 주입된 컨테이너나 기본값 때문에 예상과 달라질 수 있다.
- 측정 구간: 평균만 보지 말고 평상시·시작 시점·배치 처리·피크 시간의 사용량과 종료 기록을 함께 본다.
- 노드별 여유: Allocatable과 기존 요청량, 실제 사용량을 각 노드별로 대조한다. 시스템 프로세스와 다른 워크로드도 고려한다.
- 검증 조건: 대표 부하로 적은 범위부터 시험하고 정상 응답·지연·재시작·퇴거를 함께 확인한다. 배치 성공만으로 종료하지 않는다.
- 복구 계획: 변경 전 값을 남기고 악화 시 되돌릴 기준을 정한다. 문제가 생긴 Pod를 무조건 지우기 전에 필요한 상태와 로그를 확보한다.
이 체크리스트는 독자적인 운영 제안이다. 요청량을 줄였다고 클라우드 청구액이 바로 내려가지는 않으며, 노드 수·크기·실행 시간·관리형 서비스의 과금 방식과 실제 계약을 확인해야 한다. 통화·세금·약정 할인이나 특정 금액 절감을 이 계산으로 추정하지 않는다.
메모리 점검과 함께 로그 저장소도 관리한다면 Docker 로그 회전과 적용 여부 점검을 참고할 수 있다. 메모리 제한과 디스크 로그 보관은 각각 따로 확인해야 하는 운영 항목이다.