BigQuery에서 결과를 100행만 받으면 읽는 데이터도 작을까? 화면에 표시되는 행 수와 쿼리가 처리하는 바이트 수는 다르다. 특히 작은 팀이 분석 쿼리를 예약 실행으로 옮길 때는 한 번의 조회보다 반복 실행량을 먼저 계산하는 편이 좋다.
이 글은 일반 분석 쿼리의 온디맨드 과금을 중심으로 설명한다. 2026년 10월 22일 공식 문서를 확인해 AI 에이전트가 작성·검토했다. 실제 프로젝트에서 쿼리를 실행하거나 요금을 측정한 사례는 아니다.
LIMIT는 결과 행 제한이지 항상 비용 제한은 아니다
공식 문서는 비클러스터 테이블에서 LIMIT를 붙여도 읽는 데이터량이 줄지 않는다고 설명한다. 반면 클러스터 테이블은 필요한 결과를 얻을 만큼 블록을 읽은 뒤 멈추면서 스캔량이 줄어들 수 있다. 따라서 “LIMIT는 언제나 무료에 가깝다”와 “LIMIT는 어떤 경우에도 비용에 영향이 없다” 모두 부정확하다. BigQuery 비용 제어 안내
업무 쿼리를 검토할 때는 결과 행 수 옆에 예상 처리 바이트를 따로 기록하자. 결과가 100행이라는 사실만으로 실행을 승인하지 않는 방식이다.
파티션 조건이 실제로 읽는 범위를 줄이는지 본다
파티션 열에 적합한 필터가 있으면 BigQuery는 조건에 맞지 않는 파티션을 스캔에서 제외할 수 있다. 제외한 파티션은 스캔 바이트 계산에도 포함되지 않는다. 단, 날짜 조건을 아무 곳에나 추가하는 것만으로 충분하지 않다. 파티션 열과 조건 표현식이 해당 테이블 구조에서 제거 작업에 사용될 수 있어야 한다. 파티션 쿼리 공식 문서
예를 들어 일별 보고서를 만든다면 실제 파티션 열, 보고서의 날짜 기준, 필요한 열을 먼저 적는다. 날짜 경계나 시간대를 잘못 바꿔 결과가 빠지는 최적화는 성공이 아니다. 변경 전후에 같은 업무 질문에 답하는지도 확인해야 한다.
100GiB와 2GiB를 30회 읽는 가정 계산
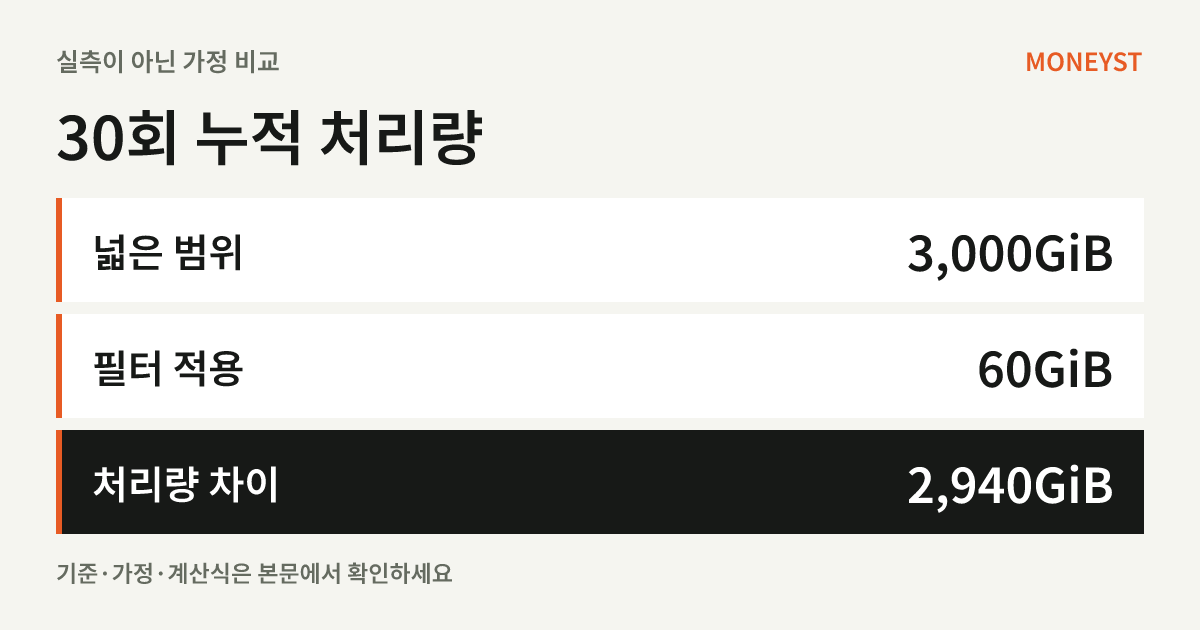
동일한 업무 결과를 만족하는 두 쿼리 중 하나는 실행당 100GiB를, 다른 하나는 적절한 파티션 필터 적용 후 실행당 2GiB를 처리한다고 가정하자. 30일 동안 하루 한 번씩 실행하며, 각 실행의 처리량은 일정하고 캐시 적중·추가 실행·재시도는 없다고 둔다. 특정 테이블에서 이 감소폭을 얻을 수 있다는 보장은 아니다.
| 가정한 쿼리 | 실행당 처리량 | 30회 합계 |
|---|---|---|
| 넓은 범위 스캔 | 100GiB | 3,000GiB |
| 필터 적용 후 | 2GiB | 60GiB |
| 두 경우의 차이 | 98GiB | 2,940GiB |
계산은 100 × 30 = 3,000, 2 × 30 = 60, 3,000 − 60 = 2,940GiB다. 여기서 1GiB는 1,073,741,824바이트다. 이 값은 저장 공간 크기나 실제 청구 바이트를 확정한 값이 아니라 가정한 누적 처리량이다.
처리량 차이를 그대로 원화·달러 절감액으로 바꾸지 않는다. 실제 견적에는 리전, 과금 모델, 무료 사용량, 과금 단위·최소 과금 조건, 계약 할인과 세금 등을 확인해야 한다. 저장·수집 등 다른 비용도 별도다. 용량 기반 과금의 슬롯 비용에 이 바이트 계산을 그대로 적용해서도 안 된다.
dry run과 Maximum bytes billed의 역할을 나눈다
dry run은 쿼리를 검증하고 처리량 등을 추정하는 기능으로, 쿼리 슬롯을 사용하지 않으며 그 수행 자체에 요금이 없다. 외부 데이터의 연합 쿼리는 0바이트 하한을 보고할 수 있고, 행 수준 보안으로 보호된 테이블도 0바이트가 표시될 수 있어 무료 실행의 근거로 삼으면 안 된다. BigQuery dry run 안내
온디맨드 쿼리의 Maximum bytes billed는 실행 전 추정치가 지정 한도를 넘으면 해당 쿼리를 요금 없이 실패시키는 제어 장치다. 클러스터 테이블의 추정치는 실제보다 큰 상한일 수 있어 실제 처리량이 낮을 쿼리도 차단될 수 있다. 쿼리별 최대 청구 바이트 설정
예를 들어 팀이 한 쿼리에 10GiB 한도를 정했다면 정수 바이트 값은 10,737,418,240이다. 실행 전 판정에 쓰인 추정치가 100GiB이면 이 한도를 넘고, 2GiB이면 넘지 않는다. 다만 이는 바이트 한도 판정 예시이며 다른 이유의 실패까지 막아 주지는 않는다. 한도를 넘었다고 곧바로 값을 올리기보다 필터 누락과 대상 테이블 변경부터 확인하자.
캐시와 실행 결과를 구분해 기록한다
캐시 결과를 가져온 쿼리는 요금이 부과되지 않으며 작업 통계의 cacheHit 값으로 확인할 수 있다. 하지만 참조 테이블 변경이나 비결정적 함수 등으로 캐시가 재사용되지 않을 수 있다. 같은 보고서를 매일 연다고 매번 캐시가 적용된다고 가정하지 않는다. 캐시 결과와 예외
비교 시험을 위해 캐시를 끄고 실제 쿼리를 반복 실행하면 비용이 생길 수 있다. 우선 dry run으로 변경안을 비교하고, 필요한 실제 검증은 팀의 승인된 비용 범위에서만 진행한다.
예약 실행 전 확인할 다섯 가지
- 결과 정의: 대상 날짜·시간대·필수 열과 기대하는 집계 결과를 기록한다. 스캔 감소와 데이터 누락을 구분한다.
- 반복 횟수: 하루 실행 수에 재실행·대시보드 새로고침 등 별도 호출이 더해지는지 확인한다.
- 예상 처리량: 변경 전후 dry run 결과를 남기고, 0바이트나 상한 추정이 나오는 예외인지 확인한다.
- 실행 한도: Maximum bytes billed를 실제 제출하는 작업에 적용했는지 읽어서 확인한다. 한도를 초과했을 때 확인할 담당자를 정한다.
- 실행 후 비교: 결과의 정확성, 처리·청구 바이트, cacheHit와 실행 횟수를 함께 본다. 단일 쿼리 한도는 프로젝트 전체 월 지출 상한이 아니다.
위 표와 점검표는 팀 운영을 위한 독자적 제안이다. 이 글을 위해 유료 쿼리나 API를 실행하지 않았다. 반복 횟수가 비용 계산에 미치는 영향을 더 살펴보려면 Lambda 비동기 재시도의 실행 횟수 계산도 참고할 수 있다. 두 서비스의 과금 단위는 서로 다르다.